jeudi 29 mars 2018

ACP sous Excel avec Xnumbers

Tout le monde l’a bien compris, le tableur est pour moi avant tout un outil pédagogique pour l’enseignement de la statistique et du data mining. Les étudiants ne peuvent pas entrer des commandes ou cliquer frénétiquement au petit bonheur la chance. Ils doivent regarder de près les formules pour pouvoir les comprendre et les reproduire. Il n’y a pas mieux pour les amener à décortiquer les différentes étapes du calcul quelle que soit la méthode étudiée.

Nous avions analysé la Régression Linéaire Multiple sous Excel récemment (Mars 2018). Dans ce tutoriel, nous explorons la mécanique d’une autre méthode phare de la data science (voir Top Data Science and Machine Learning Used in 2017) : l’analyse en composantes principales (ACP). J’en profiterai pour présenter Xnumbers, une librairie particulièrement performante pour le calcul scientifique sous Excel. Elle nous sera utile en particulier pour la factorisation des matrices à l’aide de la décomposition en valeurs singulières.

Mots-clés : analyse en composantes principales, acp, tableur excel, xnumbers
Didacticiel : ACP sous Excel
Classeur Excel : acp autos.xlsx
Références :
R. Rakotomalala, "Analyse en composantes principales - Diapos", Juillet 2013.

mardi 27 mars 2018

Autoformation avec swirl

L’autoformation est un des leviers essentiels de notre progression. J'essaie de contribuer moi-même à mon échelle à travers les supports de cours et les tutoriels. Une voie alternative est le tutoriel où on guide explicitement l'apprenant avec des systèmes de questions-réponses et des exercices contrôlés.

Le package swirl pour R fait partie de cette seconde catégorie. Une ancienne du Master SISE qui assure des formations sous R me l'a indiqué. Je la remercie pour cela. Malgré le temps que je passe sur le web à scruter ce qui se fait, beaucoup de choses m'échappent. Elle m'indiquait qu’elle l’utilisait avec succès pour ses séances de cours. Bien évidemment que je me suis rué dessus pour voir un peu ce qu'il en était, et le parti que je pourrais en tirer pour mes propres enseignements.

Dans ce tutoriel, nous essaierons de faire le tour de l'outil pédagogique en montrant son mode de fonctionnement sur un exemple de séance consacrée à la régression linéaire multiple. Nous en profiterons pour regarder un peu sous le capot et voir les éléments constitutifs des cours.

Mots-clés : autoapprentissage, autoformation, package R, logiciel R, régression linéaire multiple
Didacticiel : Apprendre R, sous R
Références :
Swirl : Learn R, in R -- http://swirlstats.com/

vendredi 23 mars 2018

Requêtes avec jointures sous R

Dans ma pratique usuelle, lorsque je dois traiter des bases multi-tables dans un processus de modélisation, j’effectue une partie du pre-processing avec des SGBD (système de gestion de base de données). Avec le langage SQL (structured query language), on y est à l’aise pour effectuer des requêtes mettant en œuvre des jointures complexes entre plusieurs sources. Au final, une table unique propice à l’analyse est produite, que j’importe ensuite dans le logiciel d’analyse statistique, que ce soit R ou Python.

Cette approche n’est pas toujours adaptée lorsque les sources initiales sont susceptibles de mises à jour fréquentes. Une modification des données nécessiterait la ré-exécution des requêtes en amont avant de pouvoir relancer le processus de modélisation. Dans ce cas, il est plus judicieux d’intégrer le code de la phase de requêtage dans le programme réalisant le traitement statistique.

Dans ce tutoriel, nous étudions les différentes solutions à notre disposition sous R pour effectuer des requêtes avec jointures. Elles ont toutes permis de répondre au cahier des charges, avec plus ou moins de facilité. Finalement, il nous appartient de choisir celle qui est la plus adaptée par rapport à notre cahier des charges.

Mots-clés : requêtes, jointures, SQL, package dplyr, fusion, tables, package sqldf
Didacticiel : Requêtes avec jointures
Données : Movies Dataset
Références :
Package "sqldf" ; package "dplyr".

vendredi 16 mars 2018

Régression linéaire sous Excel

Dans ce tutoriel, nous reprenons à partir d’un exemple traité sous Excel les principaux concepts présentés dans les documents accessibles sur ma page de cours d’Econométrie. Deux ouvrages en particulier seront mis à contribution (voir Références du document). Les principales formules seront explicitées pour chaque calcul. Elles seront mises en relation avec les opérations sous Excel. Puisque nous traitons de la régression linéaire multiple, nous ferons un usage intensif des fonctions matricielles du tableur.

Mots-clés : régression linéaire simple et multiple, excel, droitereg, fonctions matricielles
Didacticiel : Régression sous Excel
Classeur Excel : Données "cigarettes"
Références :
Cours Économétrie - Modèles linéaires
Tutoriel Tanagra, "Classeur Économétrie", avril 2015.

mercredi 14 mars 2018

Panne partielle du serveur Eric

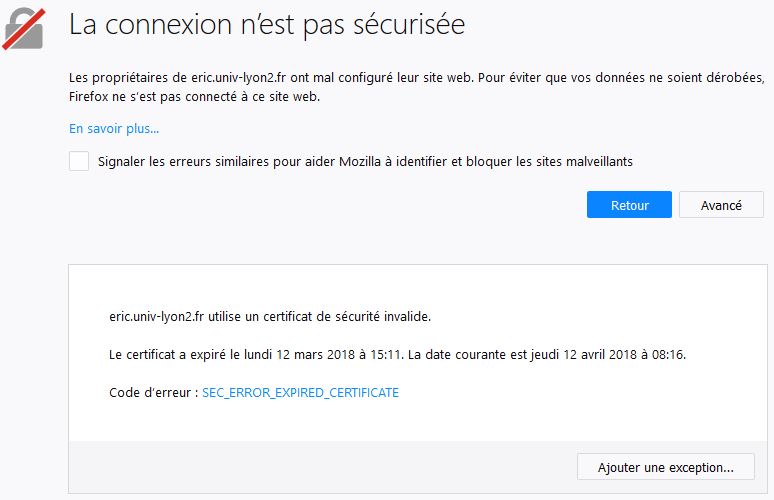
Depuis le 12 mars 2018 à 15h11, le serveur eric.univ-lyon2.fr utilise un certificat de sécurité invalide. Les accès en https nécessitent l'ajout d'une exception de sécurité. Il n'y a aucune crainte à avoir.


Je ne sais pas quand ce problème sera résolu.

Pour l'heure, la solution la plus simple consiste à modifier manuellement les adresses https en http.

Je suis désolé de ce désagrément.

Ricco.

mercredi 21 février 2018

Stratégies d'échantillonnage pour la modélisation

Ce tutoriel fait suite au support de cours consacré aux algorithmes d'échantillonnage. Nous nous y intéressions en particulier aux stratégies d'échantillonnage pour la modélisation prédictive.

Dans ce document, nous étudions expérimentalement le comportement des deux stratégies décrites dans le support. L'approche "random sampling" consiste à démarrer à partir d'une taille d'échantillon définie a priori, puis de l'augmenter graduellement tout en surveillant les performances en test (taux d'erreur). La méthode "windowing" procède du même principe mais cherche à sélectionner judicieusement les observations additionnelles à chaque étape pour améliorer la convergence.

Nos algorithmes et bases de référence seront respectivement l'analyse discriminante linéaire et les données WAVEFORM bien connus des data scientists. L'étude a été menée sous R. Mais le portage du code dans d'autres langages comme Python ne pose aucun problème conceptuel.

Mots-clés : échantillonnage, random sampling, windowing, apprentissage supervisé
Document : Stratégies d'échantillonnage pour la modélisation
Données : waveform dataset
Références :
Tutoriel Tanagra, "Algorithmes d'échantillonnage", février 2018.

mercredi 14 février 2018

Algorithmes d'échantillonnage

La volumétrie est un des enjeux clés du big data analytics. Des technologies spécifiques sont développées à cet effet. Mais d’autres stratégies existent. L’échantillonnage en est une. Dans le cadre de l’apprentissage supervisé par exemple, l’idée serait de modéliser à partir d’une fraction des données, choisies plus ou moins judicieusement, tout en s’assurant un niveau de performances équivalent au modèle qui aurait été élaboré à partir de la totalité des observations.

Mais avant d’en arriver à ce stade, il faut déjà pouvoir extraire l’échantillon à partir des données initiales. Ce support présente différents algorithmes permettant de traiter un fichier texte CSV (comma-separated value) de grande taille en accès séquentiel qu’il n’est pas possible de charger entièrement en mémoire vive. Deux grandes variantes sont explicitées : la première, plus simple, suppose connue la taille de la base initiale ; la seconde, nécessitant le chargement en mémoire de l’échantillon ou l’utilisation d’une structure intermédiaire autorisant un accès indexé, traite des fichiers où le nombre de lignes n’est pas connu à l’avance.

Des exemples de codes sources en R et Python permettent d’illustrer concrètement les solutions.

Mots-clés : échantillon, méthode de sélection rejet, reservoir sampling, fichier CSV, fichier texte avec séparateur tabulation, modélisation prédictive, logiciel R, python
Support de cours : Algorithmes d'échantillonnage
Références :
Wikipedia, "Reservoir sampling".

samedi 3 février 2018

Master SISE - Remise à niveau - Python Statistique

Le temps des recrutements pour le Master SISE va commencer bientôt. Le programme de remise à niveau pour les candidatures externes acceptées est étoffé par un chapitre consacré à Python.

L’objectif est de familiariser l’étudiant avec la manipulation des données, la réalisation des calculs statistiques simples (statistiques descriptives) ou un peu plus poussées (classification automatique, clustering). Ces exercices visent aussi à introduire quelques packages Python fondamentaux, indispensables au data scientist (pandas, numpy, scipy, matplotlib).

A la sortie, l’étudiant, j’espère en tous les cas, sera fin prêt pour suivre les enseignements où nous, mes collègues et moi-même, utilisons intensivement Python, souvent en tandem avec R (j'utilise indifféremment l'un ou l'autre pour mes cours [data mining, text mining, web mining], j'avertis les étudiants un peu avant la séance simplement pour qu'ils puissent se préparer).

Document principal : Python Statistique
Outils : Anaconda Python
Exercice 1 : Pandas, manipulation des données (Produits)
Exercice 2 : Pandas, quelques traitements (Census)
Exercice 3 : Scipy, statistiques simples et avancées (Iris)

jeudi 18 janvier 2018

R ou Python, il faut choisir ?

Une bonne manière de gâcher un repas entre informaticiens est de lancer un débat sur le meilleur langage de programmation (vécu). J’imagine qu’on aura sûrement la même chose si l’on essaie de comparer R et Python dans un dîner entre data scientist (je préfère ne pas essayer).

Mais pourquoi les opposer finalement ? Ne peut-on pas avoir fromage et dessert au même repas (pour poursuivre dans la parabole gastronomique) ? On peut former les étudiants à ces deux outils simultanément. Je les utilise moi-même de manière indifférenciée dans mes travaux dirigés en Master SISE. Et on s’en sort plutôt bien (je trouve).

C’est le discours que je vais tenir lors de la présentation au Meetup de l’association Lyon Data Science auquel je participerai ce vendredi 19 janvier 2018. En m’appuyant sur ma propre expérience d’enseignant-chercheur et de concepteur de logiciels gratuits à visée pédagogique, je vais essayer de retracer le cheminement intellectuel qui m’a amené à utiliser intensivement à la fois R et Python dans mes enseignements actuels.

Voici le résumé et le support de la présentation.

Titre : « Place de R et Python dans les formations en data science »
Résumé : La science des données n’échappe pas à la vague des logiciels libres. Depuis plusieurs années, les deux outils les plus populaires auprès des data scientists sont R et Python selon le sondage annuel du site KDnuggets (Mai 2017). Certes, les licences présentent des subtilités un peu difficiles à suivre parfois, mais elles respectent deux caractéristiques fondamentales de mon point de vue : nous avons accès au code source, nous garantissant un certain contrôle sur les calculs et opérations réellement effectuées ; ils sont accessibles et exploitables gratuitement, quels que soient les contextes d’utilisation. De fait, l’adoption de R et Python dans les formations en data science semble évidente. Pourtant, il faut être prudent, ne serait-ce que par principe. Former les étudiants à un outil n’équivaut pas à utiliser un ou des outils pour former les étudiants. Leur usage doit s’inscrire dans une démarche pédagogique cohérente qui peut s’étendre sur plusieurs années. Il ne doit pas reposer sur des effets de modes ou des popularités qui peuvent être parfois éphémères.

Dans mon exposé, je m’appuierai sur ma propre expérience d’enseignant d’une part, de créateur de logiciels de data mining gratuits à vocation pédagogique (SIPINA, TANAGRA) d’autre part, pour essayer de cerner les attentes que l’on peut avoir vis-à-vis des outils dans les cours de statistique et de data science. L’élaboration de TANAGRA (2004) en particulier aura été l’occasion de mener une réflexion approfondie sur les caractéristiques clés que doivent présenter les logiciels pour l’enseignement. Je reviendrai rapidement dessus pour mieux rebondir sur la définition d’un cahier des charges actualisé où les compétences en programmation et les accès aux API tiennent une place importante. Dans ce contexte, que l’on pourrait qualifier de Big Data, R et Python se démarquent réellement et justifient pleinement l’investissement que l’on pourrait leur consacrer au sein des formations. D’autant plus que leur présence de plus en plus marquée dans les offres d’emploi qui nous concernent directement est une autre raison qui ne peut pas nous laisser insensible. Je m’appuierais sur une étude récente réalisée par un groupe d’étudiants du Master SISE pour essayer de cerner les mots clés importants qui caractérisent les annonces dans nos domaines en France. Python y occupe un espace assez singulier.

Plusieurs démonstrations mettant en oeuvre R et Python me permettront d'appuyer mon propos.

Support : R et Python dans les enseignements
Vidéo :  Meetup à la Tour du Web
Mots-clés : data science, enseignement, formation, master data science, science de données, big data, big data analytics, logiciels libres, r, python

samedi 6 janvier 2018

Ressources partagées - Apprentissage supervisé

Antoine Rolland, un collègue qui officie à l’IUT STID de l’Université Lyon 2, m’a demandé de contribuer à la revue "Statistique et Enseignement". J’ai accepté parce que c’est lui qui me l’a demandé. Aussi parce qu’il s’agit d’une revue librement consultable, gratuitement, sans aucune contrainte.

Antoine m’a proposé de faire un descriptif commenté d’un de mes supports de cours. Ca m’a un peu titillé l’esprit. Faire l’exégèse de son propre travail n’est jamais facile. J’ai eu un peu de mal à démarrer j’avoue, puis j’ai eu beaucoup de plaisir à le faire une fois lancé. Comme tout enseignant chercheur, je parle beaucoup durant un cours, sans y penser réellement de manière explicite en amont. J’aborde tout un tas de sujets en relation d’une part avec mon expérience ou même l’actualité, d’autre part avec le profil des étudiants que j’ai en face de moi. Heureusement d’ailleurs, sinon je ne vois pas très bien l’intérêt pour nous de faire des cours magistraux (CM), à ânonner béatement la même chose tous les ans en lisant les slides. Je pense même que l’interaction est la seule justification valable encore aujourd’hui de l’existence des CM. Autrement, il y a pléthore de supports sur le web, y compris des cours en vidéo très bien faits de collègues très compétents. Décalquer avec plus ou moins de bonheur ce que dit tout le monde n’a pas vraiment d’intérêt.

J’ai choisi de travailler sur mon support de cours dédié à l’Introduction de l’apprentissage supervisé. Il s’agit d’un CM crucial où j’essaie de faire appréhender aux étudiants les notions clés de l’analyse prédictive. Chaque slide est décrit de manière approfondie, avec les commentaires qui peuvent me venir à l’esprit, les points fondamentaux qu’il faut absolument souligner pour faire comprendre aux étudiants les fondements du thème étudié, les possibles digressions qui permettent d’élargir mon propos, les réactions attendues ou inattendues du public selon leur culture et leur parcours antérieur. En rédigeant l’article, je me suis rendu compte que ces éléments font tout le sel d’un exposé. Pour nous enseignants-chercheurs, il reste encore un petit espace pour les CM en présentiel devant les étudiants.

Document : Ricco Rakotomalala, « Ressources partagées – Introduction à l’apprentissage supervisé », Statistique et Enseignement, 8(2), 43-58, décembre 2017.

mardi 2 janvier 2018

Bonne année 2018 - Bilan 2017

L’année 2017 s’achève, 2018 commence. Je vous souhaite à tous une belle et heureuse année 2018.

Un petit bilan chiffré concernant l'activité organisée autour du projet Tanagra pour l'année écoulée. L'ensemble des sites (logiciel, support de cours, ouvrages, tutoriels) a été visité 222.293 fois en 2017, soit 609 visites par jour.

Il y a une forte diminution de la fréquentation par rapport à l’année dernière (721 visites par jours en 2016), dû en partie aux pannes répétées de notre serveur. Je m’en excuse auprès des internautes qui, pendant plusieurs périodes, n’ont pas pu accéder aux supports et tutoriels.

Depuis la mise en place du compteur Google Analytics (01 février 2008), le groupe de sites a été visité 2.333.371 fois, soit 644 visites par jour.

Les visiteurs viennent en majorité de la France (52%), du Maghreb (16%) et de l’Afrique francophone. Les pages de supports de cours ont toujours autant de succès, en particuliers ceux dédiés à la Data Science et à la programmation (R et Python).

39 supports de cours et tutoriels supplémentaires ont été postés cette année : 18 en français, 21 en anglais.

En cette nouvelle année, je souhaite le meilleur à tous les passionnés de Data Science, de Statistique et d’Informatique.

Ricco.
Diaporama : Tanagra - Bilan 2017

dimanche 17 décembre 2017

LinkedIn avec Python

LinkedIn est un réseau social professionnel. Il permet de mettre en ligne notre CV, établir des contacts, entretenir des relations, accéder ou diffuser des offres d’emploi, chercher de l’aide, indiquer ses aspirations, etc. C’est un instrument privilégié pour construire notre identité virtuelle professionnelle. L’outil est particulièrement prisé des recruteurs.

Dans ce tutoriel, nous étudierons comment écrire un programme en Python permettant d’accéder aux fonctionnalités de l’API LinkedIn via le package python-linkedin. J’ai utilisé un compte LinkedIn fictif. Il s’agit avant tout de montrer la faisabilité de la chose. Nous nous attarderons sur deux étapes essentielles du dispositif : l’activation de l’API LinkedIn qui n’est pas évidente ; le package n’est pas inclus dans la distribution standard Anaconda (Python 3.6) que j’utilise, il m’a fallu l’installer et surtout le configurer (l'upgrader) spécifiquement pour qu’il fonctionne.

Mots-clés : linkedin, api linkedin, python, réseau social professionnel, package python-linkedin
Document : API LinkedIn - Python
Références :
Vantansever O., "Python-linkedin 4.0", https://pypi.python.org/pypi/python-linkedin/4.0

dimanche 3 décembre 2017

Google Analytics avec R

Google Analytics est un service de mesure d’audience des sites Web. On parle de Web Analytics. L’objectif est d’apprécier la fréquentation. Mais au-delà du simple comptage, et c’est ce qui fait réellement sa force, l’outil propose de nombreuses possibilités d’études qui permettent de mieux comprendre le comportement des visiteurs. Ainsi, en identifiant les pages les plus regardées, les pages d’entrées, en analysant les trajectoires, en ventilant les accès selon les pays, etc., il nous permet de mieux organiser notre site de manière à répondre plus précisément aux attentes des internautes.

RGoogleAnalytics est un package R permettant d’accéder aux données Google Analytics via une API (interface de programmation applicative). La librairie nous donne accès aux informations stockées par le service, tant en termes de fréquentation brute qu’en termes d’analyses préprogrammées. Ce document décrit l’utilisation sous R des fonctionnalités du package RGoogleAnalytics à partir des données du site Tanagra au sens large (pages du logiciel, mais aussi les pages relatives aux supports de cours, tutoriels, etc.) sur le mois de novembre 2017.

Mots-clés : logiciel R, google analytics, API, package rgoogleanalytics, analyse des fréquentations web, mesure d'audience, analyse factorielle des correspondances, afc, fréquentation du site tanagra
Document : R et Google Analytics
Données et programme : Prog. R et résultats des requêtes
Références :
Pearmain M. et contributeurs, "RGoogleAnalytics: R Wrapper for the Google Analytics API", August 2014.

samedi 18 novembre 2017

Les classes R6 sous R

Ce support fait suite à celui consacré aux mécanismes de classes sous R (S3, S4 et RC). Il présente le package R6 qui propose un cadre rigoureux pour l’implémentation des objets. La majorité des dispositifs présents dans les autres langages de programmation sont disponibles (C# par exemple, que j’enseigne par ailleurs en Master 2).

Nous aborderons tour à tour les notions de définition des membres d’une classe, l’accès aux champs au sein des méthodes, la portée des membres, la définition des propriétés (similaire à ce qu’on peut avoir en Delphi ou en C# justement), la hiérarchie de classes et l’héritage.

Le modèle R6 est manifestement bien conçu. Reste à savoir s’il arrivera à s’imposer au sein de la communauté des programmeurs R. Les habitudes (le modèle S3 notamment) bien ancrées sont souvent difficiles à bousculer. L’avenir nous le dira.

Mots clés : programmation objet, classes, héritage, portée, propriétés, méthodes, membres, R6
Support de cours : Les classes R6 sous R
Références :
Winston Chang, "Introduction to R6 classes", 2017.

lundi 13 novembre 2017

Ateliers : Outils de la Data Science

C’est devenu un rituel maintenant. J’ai demandé aux étudiants du Master SISE de cette année d’assurer des ateliers techniques destinés à former leurs propres collègues sur différents outils en lien avec la data science.

J’ai fait le choix de trois logiciels : SCILAB, pour qu’ils puissent se familiariser avec les environnements et langages de type Matlab ; SPAD, qui est une référence française, en particulier en ce qui concerne les composants d’analyse de données, bonifiés avec la version 9 ; SQL, qui est un langage incontournable dans notre domaine, les "sondages" de KDnuggets sur les soft de la data science le confirment tous les ans.

Les supports ci-dessous comprennent : les cours de présentation, les labs (travaux pratiques), les corrigés et les tutoriels vidéo. Tout est perfectible bien sûr. On peut toujours faire les choses mieux ou différemment ici ou là. Mais pour avoir moi-même assisté aux cours et aux labs (moi aussi, j’ai besoin de me former…), je peux assurer que chaque séance correspond à un gain en compétences substantiel.

Merci aux étudiants pour cet excellent travail qui profite à tout le monde.

Ateliers : Outils de la Data Science
ThèmesPrésentationsExercicesCorrigésTutoriels
Scilab 1
Scilab 2
Spad 1
Spad 2
Sql 1
Sql 2

Note : Mettez en HD (haute définition) les vidéos sur YouTube pour un meilleur confort de visualisation.